Instalar Modelo Entrenado
El entrenamiento de modelos de IA es un proceso computacionalmente intensivo y que consume mucho tiempo, a menudo requiriendo hardware especializado y grandes conjuntos de datos. Por esta razón, no todos los modelos se pueden entrenar directamente en LogicalDOC.
Para facilitar su adopción, el sistema permite a los usuarios instalar y usar modelos preentrenados, listos para funcionar sin necesidad de entrenamiento adicional.
Estos modelos se pueden descargar e importar a la plataforma, lo que habilita funciones avanzadas como el etiquetado de documentos y la detección de idioma con una configuración mínima.
El proceso de importación es sencillo:
1
Ingrese a la sección de modelos
Vaya a Administración > Inteligencia Artificial > Modelos
2
Descarga el archivo del modelo
El modelo que deseas importar debe ser un archivo exportado desde otra instalación o descargado del centro de descargas de LogicalDOC. Estos son los modelos preentrenados disponibles actualmente:
| Modelo | Versión | Tipo | Compatibilidad | Descripción | Descargar |
|---|---|---|---|---|---|
| zeroshot-1.0 | 1.0 | zeroshot | 9.2.3+ | Modelo de clasificación preentrenado de aprendizaje cero para generar etiquetas para documentos. Este modelo puede asignar etiquetas relevantes al texto sin necesidad de entrenamiento previo en categorías específicas, lo que permite a los usuarios definir sus propias etiquetas de forma dinámica. Analiza el significado semántico del contenido y lo compara con etiquetas candidatas, devolviendo las etiquetas más relevantes con sus respectivos índices de confianza. | |
| language-1.0 | 1.0 | language | 9.2.3+ | Modelo de detección de idiomas preentrenado de Apache OpenNLP para identificar automáticamente el idioma de un documento. El modelo admite la detección de más de 100 idiomas y devuelve códigos de idioma estandarizados ISO 639-3, lo que permite una clasificación precisa y consistente del idioma para el contenido textual. | |
| yolo4invoices-1.0 | yolo | 9.3+ | Modelo YOLO 11m utilizado para identificar objetos en imágenes, preentrenado con el conjunto de datos Fatura. Ideal para probar las capacidades de YOLO; no lo utilice en producción. | ||
| miniembedder-1.0 | 1.0 | mini-embedder | 9.3.1+ | Transformer MiniLM-L6-v2 preentrenado que convierte el texto en vectores de 384 dimensiones que representan su significado semántico. Este modelo permite realizar búsquedas semánticas y comparar documentos sin necesidad de entrenarlo con tus documentos. Se ejecuta localmente y puede utilizarse para generar representaciones vectoriales del contenido de los documentos y de las consultas de búsqueda. | |
| model-summarizer-1.0 | 1.0 | summarizer | 9.3.1+ | Transformer MiniLM-L6-v2 preentrenado que LogicalDOC utiliza para generar resúmenes de documentos. Convierte las frases en vectores de 384 dimensiones que representan su significado semántico, lo que permite a LogicalDOC identificar y seleccionar las frases más representativas. El resumen resultante conserva su redacción y orden originales. El procesamiento se realiza localmente, sin necesidad de entrenamiento adicional. |
3
Importar el archivo del modelo
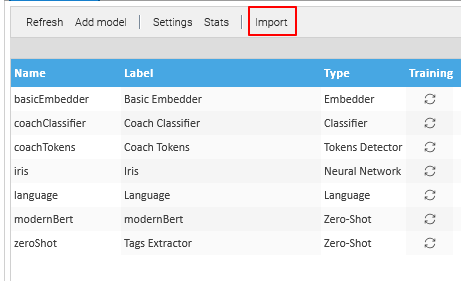
Una vez que haya descargado el archivo de su modelo, haga clic en el botón Importar.
Una vez que aparezca la ventana de Carga, haga clic en Cargar y seleccione el modelo descargado.
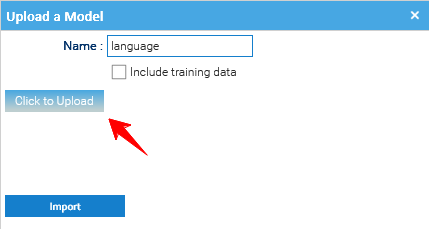
El modelo aparecerá en la lista de modelos disponibles.
4
Actualizar un modelo existente
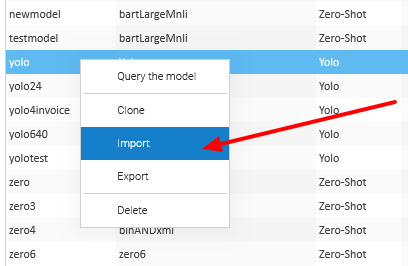
Para actualizar un modelo preexistente, basta con hacer clic con el botón derecho en el nombre del modelo en el Panel de modelos y seleccionar Importar para cargar un modelo recién entrenado.